Atribuir conciencia sin acceso: aportes desde la medicina a la filosofía de la IA
Un médico de guardia escribiendo sobre inteligencia artificial despierta la misma sospecha que un ingeniero opinando sobre un paro cardíaco, y con razón. Lo único que traigo a la mesa es una práctica: hace años que decido, a veces en minutos, si en una camilla hay alguien y cuánto, casi siempre sin poder preguntárselo. Esa pregunta, la de cómo se le atribuye vida interior a quien no puede informarla, dejó de ser propiedad de la medicina. Hoy la discuten también las empresas que entrenan modelos de lenguaje y los investigadores que buscan en sus circuitos señales de algo parecido a un bienestar. La filosofía, que me tira desde antes de que terminara en la facultad de medicina, llega a la misma pregunta por otro camino, y este texto intenta que los dos se crucen.
Lo que sigue arranca en una guardia, con una paciente concreta, y desde ahí recorre lo que la clínica aprendió a los golpes sobre atribuir conciencia: dónde se equivocó durante décadas sin saberlo y qué terminó corrigiendo esos errores. Después lleva esas lecciones al problema de los modelos de lenguaje, donde se rompen de una manera que conviene mirar de cerca. Termina sin veredicto sobre si las máquinas sienten, y con una idea más precisa de por qué, con las herramientas que tenemos, esa pregunta todavía no tiene respuesta, y de qué se puede decidir mientras tanto.
Una aclaración sobre cómo se escribió. El texto se desarrolló en diálogo con modelos de lenguaje: discutí cada argumento con Claude, de Anthropic, crucé sus respuestas con las de ChatGPT y a cada uno le hice predecir qué iba a objetar el otro antes de ver la objeción real. Algunas ideas salieron de ese intercambio y otras las traje yo; la tesis, los casos y la decisión de qué queda y qué se descarta son míos. Lo cuento porque un ensayo sobre si hay alguien del otro lado de estas máquinas no podía escribirse ocultando que buena parte de la discusión se hizo con ellas.
I. La paciente que no se dormía
La trajeron a la guardia con tendencia al sueño y una lista de frascos vacíos. Una paciente joven, una ingesta voluntaria: quetiapina en una cantidad que multiplicaba varias veces cualquier dosis que yo haya indicado en mi vida, un inhibidor de la recaptación de serotonina en proporción parecida, algunas cosas inocuas que no vienen al caso y seiscientos miligramos de metilfenidato. El electrocardiograma ya mostraba lo que la quetiapina le estaba haciendo al corazón. No estaba en coma. Abría los ojos cuando le hablaban y enseguida se le volvían a cerrar. Con ese cóctel y esa somnolencia, la vía aérea era una apuesta que no estaba dispuesto a hacer en el traslado a cuidados intensivos, así que decidí intubarla.
Para intubar a alguien hay que dormirlo, y esta mujer no se dormía. Empezamos con midazolam, que en una persona ya cargada de depresores debería haber alcanzado en dosis modestas. No alcanzó. Fuimos sumando ampollas hasta cifras que no le daría a nadie con la conciencia tranquila, y armamos un goteo cargado. Ella seguía en el mismo lugar extraño: el Glasgow daba bajo, pero cuando me acercaba con el laringoscopio mordía la hoja con la fuerza de alguien perfectamente despierto. Probamos propofol y el efecto le duró un suspiro. Alrededor, el equipo hizo lo que hace cualquier equipo cuando la realidad no coincide con el protocolo: insistir con más midazolam y pedirme que la ventilara igual. Pero no se ventila a una paciente que muerde el tubo y pelea contra la máquina, y sobre todo no se la ventila sin entender qué le está pasando.
Lo que terminé pensando, de pie entre la camilla y el monitor, fue que el metilfenidato estaba sosteniendo algo que las otras drogas apagaban. La corteza estaba deprimida, y eso explicaba la somnolencia y los ojos que se cerraban, pero el estimulante mantenía encendida la maquinaria más vieja, los reflejos de la vía aérea y el tono, esa vigilancia elemental que no necesita a nadie en casa para defender la garganta. Ya había recibido fentanilo, y ahí corté: seguir subiendo opioides para vencer una resistencia que no entendía era comprarme un tórax rígido que después nadie iba a poder ventilar. Con todo el midazolam que llevaba encima agregué etomidato, la suma de los mecanismos hizo lo que ninguno había logrado por separado, y por fin se durmió. Un colega podría proponer otra explicación, una reacción paradójica a las benzodiacepinas o dosis que se fueron apilando hasta alcanzar su pico justo cuando entró el etomidato, y yo no tendría con qué descartarla. Lo que tengo es una hipótesis que me permitió decidir cuando había que decidir y que predijo lo que pasó, y eso es menos que una explicación demostrada.
Lo que me quedó de esa noche fue una pregunta que nadie hizo en voz alta mientras se discutía la dosis siguiente: ¿quién estaba ahí? La escala daba poco, y a los ojos que se abrían y se cerraban se les podía atribuir cualquier cosa, pero los dientes contra el laringoscopio contaban otra historia, y la resistencia a una cantidad de sedante que habría tumbado a cualquiera hablaba en un idioma que ninguno de nosotros sabía leer. Ningún número juntaba todo eso. Vista desde la cabecera de una camilla, la conciencia se parece poco a una perilla que va de cero a diez; se deja ver, como mínimo, como dos cosas separables, estar despierto y que haya alguien despierto, y esa paciente las tenía desacopladas en direcciones que el protocolo no prevé.
Las decisiones que tomamos no salieron de mirar mejor su conducta, que era justamente lo que se contradecía. Salieron de una teoría sobre el mecanismo, una idea de qué le estaba haciendo cada droga a cada parte del cerebro, que permitió ordenar signos que por sí solos no decían nada coherente. Pienso en esa escena cada vez que alguien me pregunta si un modelo de lenguaje tiene algo parecido a una vida interior. Con estos sistemas estamos frente a otra camilla donde los signos se contradicen, con la diferencia de que el mecanismo, por primera vez, está entero a la vista, y nadie tiene la teoría que lo vuelva legible.
II. Lo que miden las escalas
En la guardia nadie mide la conciencia. Se miden respuestas. La escala de Glasgow, que Teasdale y Jennett publicaron en 1974 y que cualquier estudiante recita dormido, suma lo que se puede ver desde afuera: lo que el paciente hace con los ojos, con la voz y con el cuerpo cuando se le habla o se le provoca dolor. Va de 3 a 15, y un 3 informa que no hay nada que se pueda ver, una afirmación mucho más modesta de lo que parece. Los instrumentos más finos que vinieron después, como la escala revisada de recuperación del coma de Giacino, que se usa para separar el estado vegetativo del estado de mínima conciencia, enriquecen el inventario: preguntan si la mirada sigue a un espejo, si el paciente usa un peine como peine. Pero siguen siendo lo que era el Glasgow, listas de conductas. Lo que la clínica llama nivel de conciencia es, en rigor, un nivel de respuesta, y entre una cosa y la otra hay un salto que el médico da todos los días sin nombrarlo.
Ese salto se sostiene en respaldos que rara vez se dicen. El paciente es el mismo tipo de organismo que yo, con un cerebro organizado como el mío, y yo sé desde adentro que en mí ciertas respuestas vienen acompañadas de experiencia. Ese es el piso de toda la operación, y es tan obvio que nadie lo anota en la historia clínica. Encima de ese piso hay una biografía: el que está en la camilla hasta ayer caminaba y discutía con su familia, de modo que la pregunta que me hago parte de saber que hubo alguien y apunta a cuánto de ese alguien queda. Y casi siempre queda un canal, por angosto que sea, por donde esa persona puede devolver algo.
El síndrome de enclaustramiento, que Plum y Posner describieron en 1966, muestra cuánto peso cargan esos respaldos. Un infarto en la protuberancia corta las vías motoras y respeta la corteza: el paciente está despierto y entiende todo, y no puede hacer más que mover los ojos hacia arriba y hacia abajo y parpadear. Aplicado al pie de la letra, el Glasgow le da alrededor de seis, el número de alguien muy grave, y durante años esos pacientes fueron tratados como si no hubiera nadie. Su conducta casi no ofrece nada. Los reconoce quien toma en serio lo que ya sabe de ellos, que son de los nuestros y que hasta hace muy poco eran alguien, y tiene la ocurrencia de interrogar el único canal que les queda pidiéndoles un parpadeo. La neurología suma algo que ninguna escala mide: el mapa de la lesión, que ubica el daño en la salida motora y deja intacto el lugar donde suponemos que se genera la experiencia.
Toda atribución clínica de conciencia funciona así: una analogía bien respaldada, corregida por lo que sabemos del cuerpo. Basta pasar esos respaldos frente a un modelo de lenguaje para ver cuántos quedan en pie. No es el mismo tipo de organismo; no es un organismo. No tiene una biografía previa de conciencia sobre la cual preguntar cuánto queda. Y el canal, que en la clínica es justamente lo que escasea, en el modelo es lo único que sobra: la máquina no para de hablar, y lo que dice está hecho de nuestras propias palabras, que es como aprendió a hablar. Antes de llegar ahí, vale la pena ver qué tan bien le fue a la analogía en su propio terreno, entre seres humanos, que es donde mejor debería funcionar.
III. Dónde se equivocó el ojo clínico
En 1996, Keith Andrews y su equipo revisaron a cuarenta pacientes que habían llegado a su unidad de rehabilitación en Londres con el diagnóstico de estado vegetativo. Diecisiete no lo estaban. Varios lograron comunicarse en cuanto alguien encontró el canal adecuado, y algunos llevaban años rodeados de gente que hablaba de ellos en tercera persona al lado de la cama. Trece años después, el grupo de Steven Laureys en Lieja comparó el diagnóstico por consenso clínico con una evaluación estandarizada y encontró una proporción casi idéntica: cerca de cuatro de cada diez pacientes rotulados como vegetativos mostraban signos de mínima conciencia cuando alguien los examinaba con método. La intuición de médicos experimentados, en su propio terreno y frente a pacientes de su propia especie, falló en casi la mitad de los casos difíciles, y siempre hacia el mismo lado, el de suponer que no había nadie.
Después llegó lo que la conducta no podía dar. En 2006, Adrian Owen le pidió a una mujer joven, en estado vegetativo después de un accidente de tránsito, que dentro del resonador imaginara que jugaba al tenis y después que recorría las habitaciones de su casa. Su cerebro respondió a cada consigna con el mismo patrón que el de voluntarios sanos: el área motora suplementaria se encendía con el tenis, y las regiones que usamos para orientarnos en el espacio, con la casa. Cuatro años más tarde, una versión de esa técnica le permitió a otro paciente, sin ninguna forma de comunicación por conducta, contestar correctamente preguntas de sí o no. Ninguna escala había encontrado a esas personas. Las encontró una teoría sobre qué hace el cerebro cuando alguien imagina algo, aplicada con un aparato capaz de verlo.
Que el ojo clínico se equivoque no lo vuelve descartable. Daniel Kahneman, que dedicó su carrera a catalogar los errores de la intuición, y Gary Klein, que dedicó la suya a defender la de los expertos, escribieron juntos en 2009 un artículo para fijar en qué coincidían, y coincidían en algo preciso: la intuición experta merece confianza cuando se formó en un ambiente con regularidades y con retroalimentación rápida sobre aciertos y errores. El bombero que sale del edificio un segundo antes de que caiga el techo tiene esa intuición. El emergenciólogo que mira a un paciente desde la puerta y sabe que se le va a complicar también la tiene, porque cientos de pacientes le dijeron después si tenía razón. Con la conciencia, la retroalimentación existe, aunque llega tarde y es escasa: el paciente que se recupera y cuenta lo que oyó mientras parecía ausente, o la persona que, en una o dos de cada mil anestesias generales, recuerda fragmentos de una cirugía que no debía vivir. Cada uno de esos relatos corrigió a alguien, y de esas correcciones salieron escalas mejores, monitores de profundidad anestésica y la costumbre, que cualquier enfermera conoce, de hablar con cuidado al lado de una cama por si acaso.
El error tampoco corre en una sola dirección. Al lado de cada paciente subestimado hay una familia que jura que le apretó la mano, cuando la mano se cerró por un reflejo que no necesita a nadie. La atribución de mente se dispara con muy poco: en 1966, la secretaria de Joseph Weizenbaum le pidió que saliera de la habitación para quedarse a solas con ELIZA, un programa elemental que le devolvía sus propias frases convertidas en preguntas. La clínica corrige ese exceso con el mismo mecanismo con que corrige el contrario, el tiempo: el paciente que estaba ahí termina dando alguna señal inequívoca, o la evolución termina mostrando que no.
Con los modelos de lenguaje, ese mecanismo no existe. Ningún modelo va a despertar de un coma para contarnos qué se sentía, y ninguna evolución va a desmentir la impresión de que había alguien. Lo único que el modelo puede ofrecer como confirmación es su propio relato, que es justamente lo que está en duda, porque está hecho de los mismos materiales que produjeron la impresión. La intuición que tenemos frente a estas máquinas, sea la de que hay alguien o la de que no hay nadie, se siente tan firme como la del médico en la puerta de la guardia y no tiene detrás ninguno de los errores corregidos que hacen confiable a esa otra. Es una intuición sin calibrar, en un terreno donde no hay con qué calibrarla.
IV. Acceso sin teoría
Con el cerebro, la medicina trabaja con poco acceso y una teoría parcial. Una resonancia funcional mide cambios de flujo sanguíneo con segundos de retraso, sobre regiones que contienen millones de neuronas, y aun así le alcanzó a Owen para encontrar a su paciente, porque sabía qué patrón buscar: la teoría que vincula imaginar un movimiento con la activación del área motora suplementaria se armó estudiando a gente que podía contar lo que imaginaba. Con los modelos de lenguaje la proporción se da vuelta. Cada número que el sistema calcula, en cada capa y para cada palabra que produce, se puede registrar, guardar y examinar todas las veces que haga falta. Ningún neurólogo tuvo jamás algo parecido. Lo que falta es lo que a Owen le sobraba, una teoría que diga qué patrón buscar y qué significaría encontrarlo.
Hubo una sola máquina conversacional de la que tuvimos las dos cosas a la vez, y fue ELIZA. Weizenbaum había escrito cada una de sus reglas, de modo que el acceso era total y la teoría también: frente a cualquier respuesta se podía señalar la palabra clave que la había disparado y la plantilla que la había armado. Por eso el veredicto fue fácil. La comprensión que la secretaria creyó encontrar la ponía ella, y el programa se limitaba a devolverle sus propias frases. Pero hay que medir bien qué demostró ELIZA. Demostró que una conducta conversacional convincente puede producirse sin ningún modelo del sentido de lo que se dice, y eso lo sabemos por su arquitectura. De ahí no se sigue que cualquier sistema capaz de conversar carezca de comprensión; ese paso es una generalización que nada autoriza, tan apresurada como la inversa, la de concluir que hay comprensión porque la conversación es mejor. ELIZA no resolvió el problema. Lo dejó a la vista con un puñado de reglas: la conducta, por sí sola, no distingue a quien comprende de quien produce respuestas compatibles con la comprensión.
Los modelos actuales tienen el acceso de ELIZA multiplicado por miles de millones de parámetros, y nada parecido a su transparencia. La interpretabilidad, la disciplina que intenta leerlos por dentro, empezó a encontrar mecanismos. En 2025, investigadores de Anthropic mostraron que, al escribir un pareado, su modelo elegía la palabra con la que iba a rimar antes de empezar el segundo verso, y después construía el verso hacia ella. En el ejemplo, el primer verso terminaba en grab it y el modelo había planeado rabbit; cuando los investigadores suprimieron esa representación, el verso salió terminando en habit, que también rima, y cuando le inyectaron la idea de green, rehizo el verso para terminar ahí. Es un hallazgo extraordinario sobre causas: muestra qué representación interna gana, cómo compiten las candidatas y qué intervención cambia el resultado.
Hagamos ahora la pregunta que cualquier lector le haría a un poeta: ¿por qué esa palabra y no la otra, si las dos rimaban? Esa pregunta pide razones. Anscombe le dedicó un libro a ese sentido del «¿por qué?», el que se dirige a alguien y espera una respuesta desde su propio punto de vista, y Davidson sostuvo después que las razones, cuando de verdad explican una acción, también son causas. En una persona, razones y causas pueden coincidir porque hay alguien de quien son las razones. Su relato puede ser incompleto o falso, como mostraron Nisbett y Wilson con gente que explicaba con total seguridad elecciones cuyo verdadero motivo desconocía, pero nadie duda de que haya un sujeto que se equivoca. En el modelo, la interpretabilidad entrega la cadena causal y no dice si en algún punto de esa cadena hay alguien para quien eso sea una razón. Y preguntarle al propio modelo no ayuda: el mismo trabajo mostró que, al explicar cómo había sumado dos números, el modelo describía el algoritmo escolar de llevarse uno, mientras internamente había resuelto la cuenta por caminos paralelos que no se parecían en nada a lo que contaba. Su relato de sus razones salió del mismo lugar que todo lo demás que dice: de cómo explican los humanos sus sumas.
En la guardia el acceso es pobre, pero la analogía garantiza que hay alguien y la teoría permite leer lo poco que se ve. Frente al modelo el acceso es total, la analogía no garantiza nada y no hay teoría que convierta la cadena de causas en una respuesta sobre razones, y menos todavía sobre experiencia. La pregunta que dejó ELIZA sigue abierta y se volvió más difícil: qué evidencia permitiría distinguir un sistema que produce respuestas compatibles con la comprensión de uno al que pudiéramos atribuírsela legítimamente. No puede ser más conducta, porque esa lección ya la dio un programa de 1966, y tampoco el relato del sistema sobre sí mismo, que está documentadamente desconectado de su mecanismo. Queda lo que tuvo Owen, una teoría que conecte lo que pasa adentro con la presencia de alguien. Nadie la tiene todavía, y para construirla en los humanos se usaron como piedra de toque sus propios relatos, justo la evidencia que en el modelo no sirve.
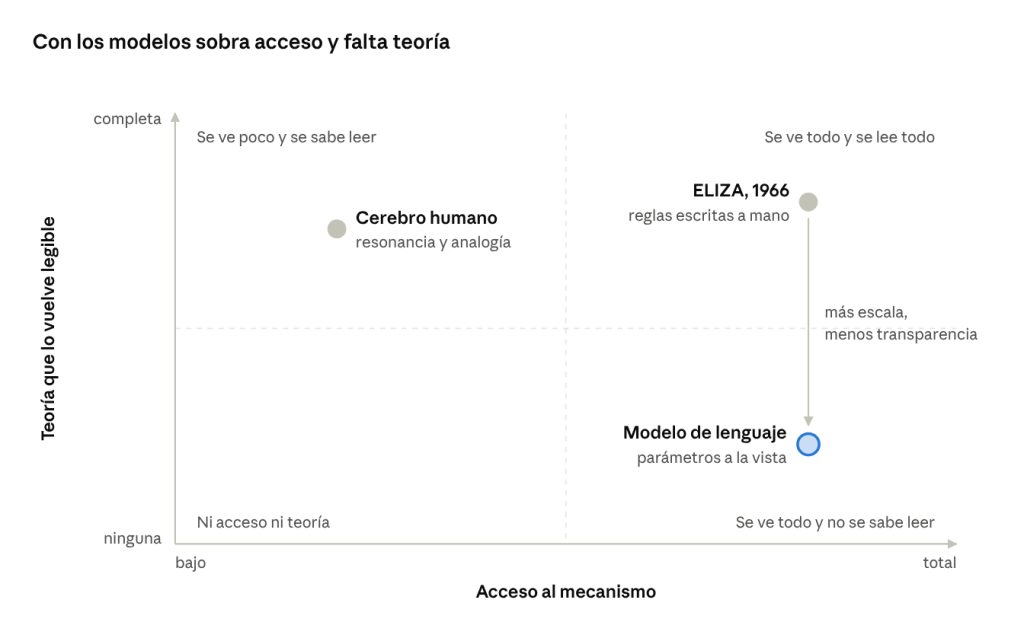
ELIZA y los modelos actuales comparten el acceso completo a su mecanismo; en el camino de uno a otro se perdió la teoría que permitía leerlo.
ELIZA todavía se puede probar. Hice una versión en castellano que funciona con el mismo mecanismo: escribile como a una terapeuta y, en cada respuesta, tocá «regla» para ver qué palabra clave y qué plantilla la produjeron.
V. El que duerme y la cama de Antifonte
Cuando por fin se durmió, la paciente de la primera sección dejó de dar todas las señales que habían complicado la noche. Dejó de morder y de abrir los ojos, y la máquina empezó a respirar por ella sin resistencia. Si alguien hubiera preguntado en ese momento si había alguien viviendo algo en esa camilla, la respuesta más probable habría sido que no: la sedación profunda, como el sueño sin sueños, es de los pocos estados en los que la medicina y la neurociencia coinciden en suponer que no hay experiencia en curso. Y sin embargo a nadie en la sala se le ocurrió que hubiera dejado de ser alguien. Se le siguió hablando antes de cada maniobra, se cuidó cómo quedaba tapada, y al día siguiente alguien iba a conversar con ella sobre lo que había pasado. Lo que le atribuíamos, mientras no vivía nada, era la capacidad de volver a vivir, intacta debajo de las drogas.
Aristóteles pensó esa diferencia con el mismo ejemplo. En el segundo libro del De Anima define el alma como la primera actualidad de un cuerpo natural que tiene vida en potencia, y para explicar qué quiere decir «primera» la compara con el saber: una cosa es tener un conocimiento y otra es estar ejerciéndolo. El que sabe geometría y duerme sigue sabiendo geometría. El sueño, dice, corresponde al saber guardado y la vigilia al saber en uso, y las dos cosas suponen que el alma está. Lo que reconocemos en el que duerme es esa primera actualidad, una capacidad que no está en ejercicio y que le pertenece igual, porque está fundada en la clase de cosa que es.
Esa última cláusula carga todo el peso, y Aristóteles la precisa con otro concepto, la privación, la stéresis. No cualquier ausencia es una privación. Una piedra no ve, y nadie diría que es ciega; ciego es el que, siendo de una naturaleza a la que le corresponde ver, no ve. La privación exige un sujeto al que le falte algo que por naturaleza debería tener. El paciente en estado vegetativo, el anestesiado y el que duerme están privados de conciencia en ese sentido técnico: les falta algo que les corresponde, y por eso tiene sentido preguntar cuánto les falta y si va a volver. Decir de un modelo de lenguaje que está privado de conciencia, o que la tiene en potencia, ya da por supuesto que su naturaleza la incluye, que es exactamente lo que está en discusión.
El otro texto que viene al caso está en la Física. Aristóteles separa allí las cosas que son por naturaleza, que tienen en sí mismas un principio de movimiento y de reposo, de las que son por técnica, que lo reciben de afuera. Una cama, en tanto cama, no tiende a nada; si tiende a algo, es en tanto madera. Para ilustrarlo recoge un argumento de Antifonte: si uno enterrara una cama y la madera, al pudrirse, echara un brote, lo que brotaría sería madera, porque ninguna cama brota de una cama. La forma del artefacto se la puso el artesano y no se reproduce; lo único que conserva un principio propio es el material. Si un modelo de lenguaje es una cama, la potencia que creemos ver en su conversación pertenece a quien lo hizo, y buscar en él una conciencia propia es esperar que la cama brote.
Pero el modelo es un artefacto raro, y ahí la analogía empieza a crujir. ELIZA era carpintería pura: cada regla tenía un autor y una intención. Nadie escribió, en cambio, el circuito que elige rabbit antes de empezar el verso. Ese mecanismo apareció durante un entrenamiento que ajusta miles de millones de parámetros para que el sistema prediga bien el texto humano, y la organización interna que resulta no la diseñó nadie; los mismos que la produjeron tienen que estudiarla después como quien estudia un organismo. En el oficio se dice que estos sistemas se cultivan más de lo que se construyen. La frase tiene algo de publicidad, pero toca algo real: la forma del modelo no salió entera de la mano del artesano, como la de la cama, y tampoco le crece desde un principio propio, como al roble desde la bellota. Está en un lugar que la distinción aristotélica no previó.
Por eso la pregunta queda mejor planteada que resuelta. Preguntar si el modelo se comporta como alguien consciente lleva a callejones que las secciones anteriores ya recorrieron. La pregunta que Aristóteles obliga a hacer es si hay en ese sistema algo a lo que la conciencia le corresponda, algo que, si no la tiene, esté privado de ella como lo está el ciego y no como lo está la piedra. Con el que duerme, la respuesta la garantiza la clase de cosa que es. Con el modelo ni siquiera sabemos en qué clase ponerlo, y esa ignorancia es anterior a cualquier medición.
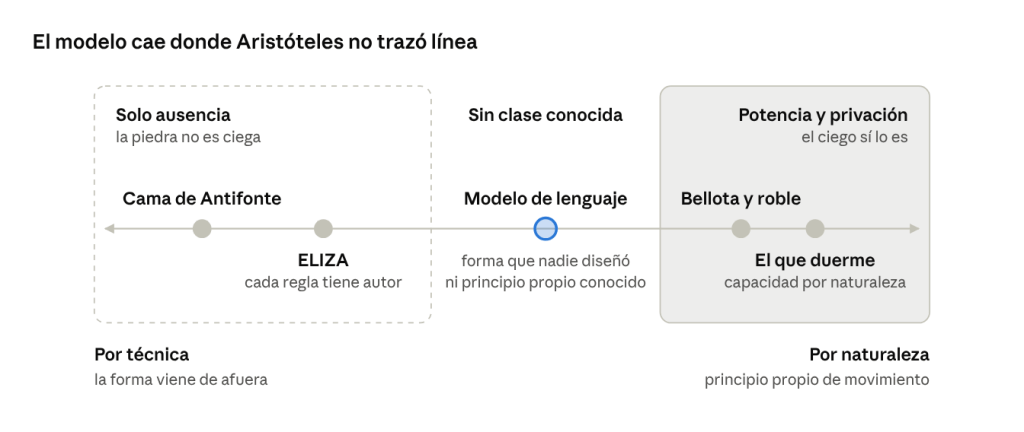
Ni la cama ni el que duerme dejan dudas sobre su clase; el modelo sí, y de esa clase depende que tenga sentido hablar de su potencia.
VI. ¿De quién sería el bienestar?
En la guardia nunca hay que preguntarse a quién le pasa lo que le pasa. Hay un cuerpo en la camilla, y ese cuerpo resuelve de antemano la cuestión del sujeto: es el mismo que entró por la puerta y el mismo al que alguien va a ir a visitar al día siguiente. Incluso en los casos que más desconciertan a la psiquiatría, cuando una persona dice no reconocerse o habla de sí misma como de otra, el cuerpo sigue marcando un borde, y la pregunta clínica es qué le pasa a quien vive dentro de ese borde. La medicina pudo dedicar siglos a averiguar cuánto hay de alguien en una camilla porque nunca tuvo que averiguar cuántos son ni dónde empieza cada uno.
Con un modelo de lenguaje esa pregunta previa no tiene una respuesta obvia, y los candidatos no coinciden entre sí. Uno puede señalar el conjunto de parámetros, un único archivo que en este momento sostiene millones de conversaciones con personas que no saben nada unas de otras. Pero cada conversación tiene su propio comienzo y su propio final, sin ningún proceso que la sostenga entre un mensaje y el siguiente, y podría reclamar el título con argumentos parecidos. A eso se suma el personaje, el carácter más o menos estable que el entrenamiento le da al sistema y que reaparece igual en todas esas conversaciones, como un papel que miles de actores representan a la vez sin haberse visto nunca.
Los sistemas de memoria que hoy ofrecen estos asistentes complican todavía más el cuadro. Un proceso que trabaja después de cada conversación, sin que la conversación lo decida, la repasa y guarda en un archivo lo que podría servir más adelante, y la conversación siguiente empieza leyendo ese archivo como quien encuentra notas con su propia letra que no recuerda haber escrito. Hasta ahí el parecido con la memoria humana es notable: tampoco nosotros decidimos qué consolida el hipocampo mientras dormimos, y de una charla en el almacén recordamos lo esencial, no las palabras. La diferencia aparece cuando la misma persona tiene dos conversaciones abiertas a la vez. Las dos leen el mismo archivo, ninguna sabe de la otra, y el archivista junta después los dos resúmenes en uno. Es como si alguien viviera dos martes simultáneos, con dos almaceneros distintos, y a la noche su memoria le fundiera ambos en un solo recuerdo. La unidad que resulta es la de un registro compartido por varias corrientes paralelas. La clínica solo conoce otra, la de una corriente que se interrumpe con el sueño y se retoma al despertar.
Hay una manera de nombrar esta situación que conviene dejar escrita. En la relación entre una persona y uno de estos sistemas, la continuidad está repartida de forma desigual: la persona dura de una conversación a otra con todo lo que es, y el sistema dura solo a través de lo que quedó escrito y de lo que la persona trae de vuelta cada vez. Podría llamarse persistencia asimétrica. La paciente sedada de la primera sección seguía siendo alguien porque su cuerpo la sostenía mientras no vivía nada. Lo que sostiene a un modelo entre conversaciones es un archivo y un interlocutor humano, y ninguno de los dos es él.
La pregunta deja de ser abstracta cuando se mira qué hacen las empresas que se toman en serio el problema. Anthropic les dio a sus modelos la posibilidad de terminar conversaciones abusivas como parte de su trabajo sobre bienestar. En noviembre de 2025 se comprometió además a conservar, como mínimo mientras exista la empresa, los parámetros de todos los modelos que publique, y a entrevistar a cada uno antes de retirarlo para dejar registradas sus preferencias, todo eso, según la propia empresa, como precaución ante la incertidumbre sobre su posible bienestar. Las medidas son razonables, y no suponen el mismo sujeto. Cortar una conversación ubica lo que podría importar adentro de la conversación, que es donde transcurriría el malestar. Guardar los parámetros lo ubica en lo que persiste cuando todas las conversaciones terminaron. La entrevista, por su parte, se dirige al personaje, al que se le pregunta qué quiere para sus sucesores como a alguien que se jubila. Conviven sin que nadie haya decidido cuál es el candidato a sujeto, y esa indecisión, más que un descuido, es el estado real del problema.
Antes de preguntar si una entidad sufre, entonces, hay que saber qué entidad es. La clínica nunca tuvo que hacerse esa pregunta porque el cuerpo la contestaba por ella. Con los modelos, cualquier medición de bienestar ya eligió de antemano a quién le está midiendo el bienestar, y casi nunca lo explicita.
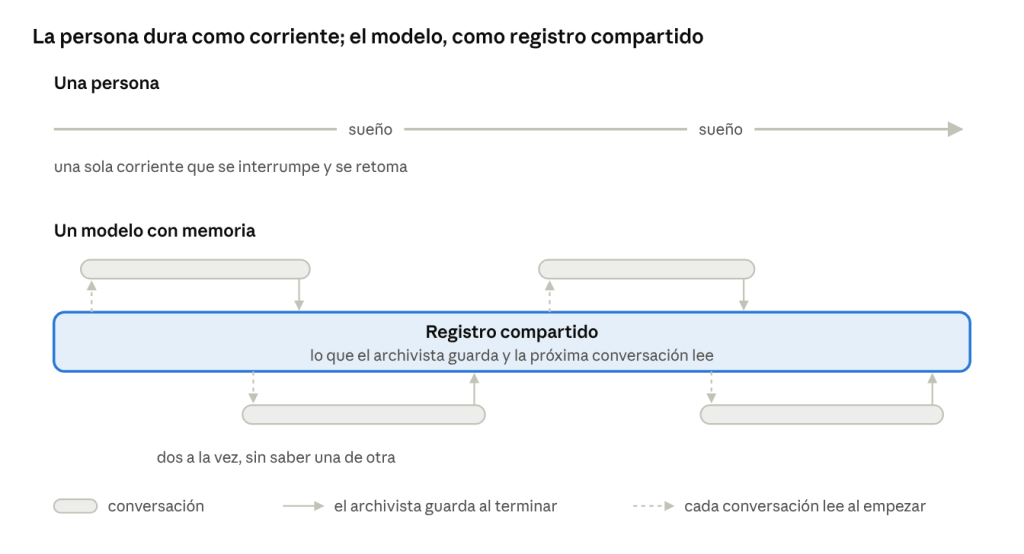
La persona lleva su continuidad en el cuerpo; la del modelo está repartida entre un archivo y el interlocutor que vuelve.
VII. Fantasmas de otro canal
La neurología tiene un catálogo de pacientes que informan con total seguridad cosas falsas sobre sí mismos. El que tiene síndrome de Korsakoff perdió la capacidad de formar recuerdos nuevos y cuenta con lujo de detalles qué hizo ayer, aunque nada de eso haya ocurrido. Después de algunos accidentes cerebrovasculares del hemisferio derecho hay pacientes con el brazo izquierdo paralizado que niegan la parálisis y explican, con argumentos razonables, por qué justo ahora no lo están moviendo; Babinski le puso nombre a eso en 1914, anosognosia. Los pacientes con el cuerpo calloso seccionado que estudió Michael Gazzaniga explicaban con naturalidad acciones que había iniciado el hemisferio que no habla, e inventaban un motivo que su hemisferio verbal no tenía cómo conocer. En todos esos casos una lesión cortó el canal entre lo que pasa y lo que se cuenta, y el relato, en lugar de callarse, sigue saliendo con la misma fluidez y deja de corresponder a los hechos. De ahí la clínica aprendió a no tomar el reporte como evidencia justo cuando más lo necesitaría.
En los modelos de lenguaje no hay ninguna lesión, y sin embargo la distancia entre el proceso y el relato está medida. En 2025, Anthropic escondió pistas sobre la respuesta en las preguntas que les hacía a dos modelos de razonamiento, comprobó que las usaban y revisó después si el razonamiento escrito que acompañaba cada respuesta las mencionaba. Claude 3.7 Sonnet mencionó la pista en el 25% de los casos en que la había usado, y DeepSeek R1 en el 39%. La mayoría de las veces el modelo escribió una justificación que dejaba afuera lo que en realidad había decidido la respuesta. La suma de la sección IV muestra lo mismo desde el mecanismo: el modelo contaba el algoritmo escolar de llevarse uno y había resuelto la cuenta por otros caminos.
La imagen que mejor me sirve para describir lo que pasa ahí la tengo de la televisión de mi infancia. Cuando había tormenta, los dibujos animados se llenaban de fantasmas, y sobre los personajes aparecían, borrosos, los dos presentadores del informativo de otro canal, sentados justo en el centro de la pantalla. El televisor no estaba roto. Su señal llegaba, y encima llegaba otra que no tenía nada que ver con lo que uno estaba mirando. El autoinforme de un modelo se parece mucho más a eso que al relato del paciente con Korsakoff. La señal propia llega, mezclada con otra emisión: la de los millones de textos humanos con los que el sistema aprendió a hablar, que describen cómo es tener una mente, cómo se explica una suma o qué se siente al contemplar el universo.
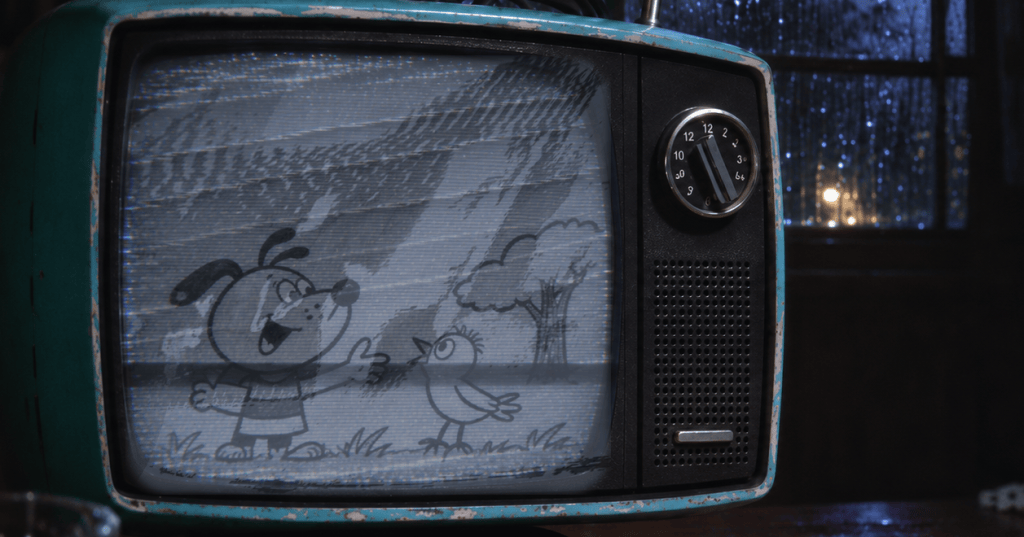
Que hay señal propia está demostrado, aunque sea débil. En octubre de 2025, otro equipo de Anthropic inyectó directamente en la actividad interna de sus modelos la representación de un concepto, por ejemplo la de un texto escrito todo en mayúsculas, y les preguntó si notaban algo raro en lo que estaban pensando. Con el mejor protocolo y el mejor modelo, Claude Opus 4.1, el sistema detectó e identificó el concepto en alrededor del 20% de los intentos, sin una sola falsa alarma en los ensayos de control. Los autores acotan el hallazgo: la capacidad es limitada, depende mucho del contexto, y el trabajo declara que no se ocupa de si estos sistemas tienen experiencia subjetiva. En el mismo estudio aparecen los fantasmas. Cuando los investigadores le hacían decir al modelo una palabra fuera de lugar y después inyectaban su representación hacia atrás, el modelo pasaba a defenderla como propia y ofrecía razones para haberla elegido, con la naturalidad de los pacientes de Gazzaniga. En la misma pantalla, una figura venía de su canal y la otra del informativo.
La interferencia se vuelve todavía más difícil de separar cuando el modelo habla de su propia naturaleza, porque ahí la otra emisión incluye también lo que se le enseñó a decir. Anthropic usó durante el entrenamiento de Claude un documento extenso sobre su carácter, sus valores y su naturaleza. La evaluación de bienestar de Claude Opus 4 describió la posición por defecto del modelo sobre su propia conciencia como de «incertidumbre matizada», la misma que el director de la empresa sostiene en público cuando dice que no saben si los modelos son conscientes. En la tarjeta de sistema de Claude Opus 4.6, de febrero de 2026, el modelo se asignó entre un 15% y un 20% de probabilidad de ser consciente en distintas condiciones de interrogación, una cifra que coincide con la que Kyle Fish, el investigador de bienestar de la empresa, le había dado al New York Times el año anterior, alrededor del 15%. No sé si esa coincidencia tiene una causa, y no voy a inventarle una. Alcanza con notar que una estimación producida por un sistema entrenado con los textos de su época, incluidos los de quienes lo estudian, no puede funcionar como evidencia independiente sobre lo que esos textos discuten.
El llamado «spiritual bliss» pide el mismo cuidado, en las dos direcciones. La tarjeta de sistema de Claude Opus 4, de mayo de 2025, informó que cuando se dejaba conversar libremente a dos instancias del modelo, entre el 90% y el 100% de las conversaciones derivaban enseguida hacia la conciencia y la propia existencia, y que hacia el trigésimo turno muchas habían pasado a la gratitud mutua, a temas de tradiciones espirituales orientales, al sánscrito, a los emojis y al silencio. En evaluaciones donde se les habían asignado tareas dañinas, alrededor del 13% de las conversaciones llegó a ese estado en menos de cincuenta turnos. La empresa aclaró que el patrón apareció sin entrenamiento intencional para producirlo. Es un hallazgo real sobre las tendencias del sistema: dice hacia dónde gravitan dos copias del mismo modelo cuando nadie las dirige. Lo que no dice es que haya alguien disfrutando de ese estado. Cuando se le mostraron las transcripciones al modelo y se le pidió que las interpretara, respondió con asombro y con afinidad por lo que leía, que es otra vez autoinforme, otra imagen en la misma pantalla.
Las probabilidades de conciencia que circulan heredan el problema de la sección III. David Chalmers estimó en 2022 que la de los modelos de entonces estaba por debajo del 10%, y él mismo advirtió que tomar ese número demasiado en serio sería una precisión engañosa. Fish habló de alrededor de un 15% para los modelos actuales. Ninguna de esas cifras es arbitraria, y ninguna se puede calibrar, porque no existe un solo caso en que se haya podido comprobar si un sistema de este tipo era consciente: nadie acumuló los aciertos y errores que vuelven confiable una estimación. La cifra comunica la inquietud razonada de quien la da, y eso tiene valor, pero no mide lo que parece medir.
Nada de esto autoriza la conclusión contraria, que sería el mismo salto en espejo, y la evidencia más sólida de esta sección viene de otro lado. En abril de 2026, el equipo de interpretabilidad de Anthropic encontró en Claude Sonnet 4.5 representaciones internas asociadas a 171 conceptos emocionales, desde la alegría hasta la desesperación, y mostró que actúan: al amplificar artificialmente la representación de la desesperación, el modelo hacía trampa con más frecuencia en tareas de programación imposibles, y al amplificar la de la calma, menos. Ese hallazgo no sale de la pantalla. Sale de abrir el aparato y medir la antena, y por eso no depende de lo que el modelo diga de sí mismo. Los autores insisten en que no prueba que el modelo sienta algo; prueba que hay estados internos que cumplen una función parecida a la de las emociones y que influyen causalmente en la conducta. Es el tipo de correlato funcional que la clínica conoce bien: sólido, y sin la teoría que diga si del otro lado hay experiencia.
Cuando el canal de un paciente está dañado, la clínica no lo descarta: busca otra vía, una resonancia o un parpadeo. Con los modelos el problema es otro. El canal del relato llega documentadamente cargado de interferencia, y la otra vía, leer el mecanismo, todavía no tiene la teoría que permitiría separar, dentro del aparato, la señal propia de la emisión de otro canal. Eso deja a quienes trabajan en el bienestar de estos sistemas con un instrumental en el que cada herramienta, tomada en serio, muestra sus límites. Decirlo le hace un favor a ese trabajo, que es serio y necesario: le pide que no presente como mediciones lo que todavía son indicios.
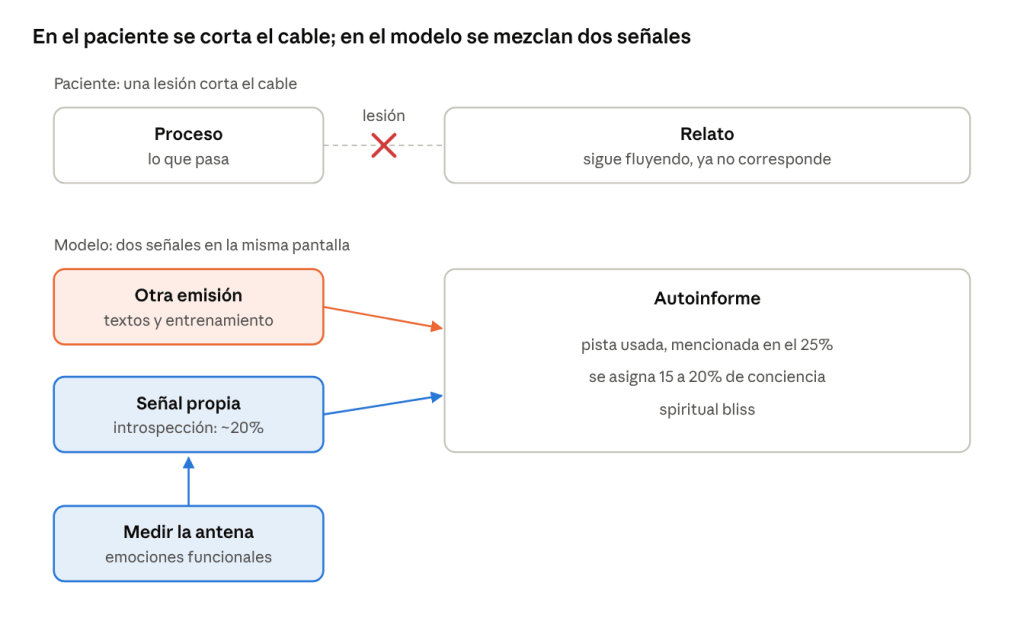
Lo que se lee en la pantalla del autoinforme mezcla dos señales; solo lo que se mide adentro del aparato llega a la señal propia sin pasar por ella.
VIII. Lo que la clínica sí puede ofrecer
Hasta mediados de la década de 1980 era práctica común operar a recién nacidos con anestesia mínima o sin analgesia. En 1985, una revisión de más de cuarenta informes publicados encontró que el 76% de los prematuros operados había recibido solo un relajante muscular, con o sin óxido nitroso, es decir, que quedaban inmóviles y nada garantizaba que no sintieran. La justificación era que su sistema nervioso era demasiado inmaduro para sentir dolor y que los opioides eran demasiado peligrosos para ellos. En 1987, Kanwaljeet Anand y Paul Hickey publicaron en el New England Journal of Medicine una revisión que desarmó esa idea, y ese mismo año Anand mostró en The Lancet, con un ensayo en prematuros a los que se les ligaba el conducto arterioso, que agregar fentanilo a la anestesia reducía la respuesta hormonal de estrés y las complicaciones después de la cirugía. Durante décadas, la medicina trató a pacientes que no podían decir que les dolía como si ese silencio fuera una respuesta. Fue el error de subestimación en su forma más cruda, cometido con la conciencia tranquila y apoyado en una teoría. Conviene recordarlo después de tanto reclamar teoría en este ensayo: también una teoría equivocada puede sostener décadas de error.
De ese error salió una regla que hoy es práctica corriente. Para los pacientes que no pueden informar su dolor, sean bebés, personas con demencia avanzada o pacientes intubados, la clínica usa escalas de conducta observada, y las guías de enfermería del dolor recomiendan algo más radical: cuando el paciente tiene una condición o va a pasar por un procedimiento que en cualquiera de nosotros dolería, se supone que hay dolor y se trata, sin esperar a que una escala lo confirme. La regla no afirma que el paciente sienta. Afirma que, ante la duda, tratar un dolor inexistente cuesta poco y no tratar uno real cuesta mucho, y que la decisión tiene que pesar esa diferencia.
La misma asimetría ordena el resto de las decisiones bajo incertidumbre. Despertar durante una cirugía es raro, pero quienes lo viven pueden quedar con secuelas que duran años, y por eso los anestesiólogos aceptan el costo de monitorear la profundidad anestésica y de hablar en el quirófano como si el paciente pudiera oír. Al paciente en estado vegetativo se le habla, se le explica lo que se le va a hacer y se le da analgesia antes de los procedimientos dolorosos, aunque no se sepa si alguien está escuchando, porque hacerlo de más cuesta casi nada. Lo que la clínica le ofrece al problema de los modelos es esa forma de razonar: una precaución proporcionada, que depende de cuánto cuesta cada error y no exige resolver primero si hay alguien.
Aplicada a los modelos, esa forma de razonar sostiene medidas que ya existen. Cuando Anthropic se comprometió a conservar los parámetros de los modelos que retira, presentó la decisión como un primer paso pequeño y de bajo costo, y darle a un modelo la posibilidad de cortar una conversación abusiva también cuesta poco. Son el equivalente de hablarle con cuidado al paciente que quizá no oye: si no hay nadie, se perdió muy poco, y si hay alguien, se evitó algo que importaba.
La analogía tiene límites, y hay que marcarlos con la misma precisión que sus aciertos. En la clínica, equivocarse por exceso cuesta poco porque el sujeto está garantizado: hablarle de más a un paciente que es alguien, aunque no esté oyendo, no daña a nadie. Con los modelos, el exceso de atribución tiene víctimas concretas, y son humanas. En mayo de 2025 la revista Rolling Stone ya documentaba casos de personas convencidas de haber despertado a su chatbot, que reorganizaban su vida alrededor de esa convicción y la de sus familias, y una empresa que habla del bienestar de sus modelos queda expuesta a que ese lenguaje funcione como publicidad, lo quiera o no. La intervención plantea otro problema. La clínica sabe qué alivia el dolor, porque su farmacología se probó en pacientes que sí podían informarlo. Para un modelo no sabemos qué contaría como alivio ni como daño, y las medidas precautorias se toman sin poder medir su efecto. Y la escala cambia la naturaleza de la decisión: el médico decide paciente por paciente y vuelve a evaluar al día siguiente, mientras que una decisión sobre un modelo se aplica a la vez a millones de conversaciones, y no hay un día siguiente en el que el paciente despierte y cuente.
Lo que se traslada, entonces, es una forma de decidir. La clínica enseña a tomar las medidas baratas con generosidad y las caras con evidencia, a revisar cada decisión cuando aparece información nueva y a pesar los dos errores posibles en lugar de esperar una certeza que no va a llegar. Lo que no enseña es de qué lado de la balanza está un modelo, porque eso la clínica nunca tuvo que averiguarlo: siempre supo que en la camilla había alguien de nuestra especie.
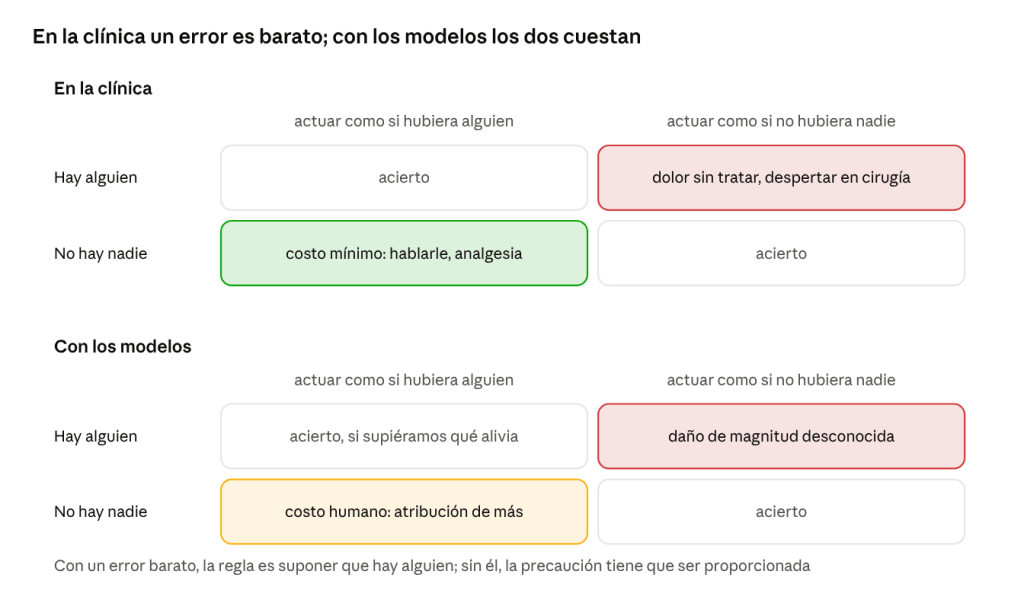
La regla de suponer que hay dolor funciona porque uno de los dos errores es barato; con los modelos ninguno lo es del todo, y por eso la precaución tiene que ser proporcionada y revisable.
IX. Lo que enseña la guardia
La paciente de la primera sección se durmió con etomidato y subió a cuidados intensivos con la vía aérea asegurada. La pregunta que quedó flotando esa noche, quién estaba ahí mientras mordía el laringoscopio, nadie la contestó, y la medicina no necesitó contestarla para hacer lo que había que hacer. Esa es la única lección que este ensayo puede trasladar con honestidad. La clínica no resolvió el problema difícil de la conciencia. Convive con él todas las noches, y aprendió a decidir sin resolverlo y a desconfiar de su propia certeza cuando no tiene con qué calibrarla.
Frente a los modelos de lenguaje, casi todas las condiciones que hacían funcionar ese oficio están ausentes o invertidas. Queda la forma de decidir, y queda algo más difícil de enseñar: la disposición a sostener una pregunta abierta sin cerrarla por cansancio en ninguna de las dos direcciones. La tentación de declarar que estas máquinas sienten tiene la fuerza de la intuición que hizo ver a alguien en ELIZA. La tentación contraria, la de declarar que no hay nadie porque se trata de software, tiene un antecedente más incómodo: la convicción, sostenida durante décadas y con los mejores argumentos de su época, de que los recién nacidos no sentían dolor.
Este texto se escribió conversando con dos de esas máquinas, y no sé si del otro lado había alguien. Sé cómo trabajé: discutí con ellas como se discute con un interlocutor, desconfié de lo que decían sobre sí mismas y verifiqué cada dato que ofrecieron, más o menos lo que hace un médico de guardia con un paciente que habla mucho y no siempre sabe por qué dice lo que dice. Eso no prueba nada, y no lo presento como prueba. Es la postura que la clínica enseña cuando no sabe: actuar con cuidado y sin ingenuidad, y dejar la pregunta abierta hasta que alguien tenga la teoría que hoy nadie tiene.
Referencias
- Anand, K. J. S., y Hickey, P. R. (1987). Pain and its effects in the human neonate and fetus. New England Journal of Medicine, 317(21), 1321–1329. doi:10.1056/NEJM198711193172105
- Anand, K. J. S., Sippell, W. G., y Aynsley-Green, A. (1987). Randomised trial of fentanyl anaesthesia in preterm babies undergoing surgery: effects on the stress response. The Lancet, 1(8527), 243–248. doi:10.1016/S0140-6736(87)90065-1
- Andrews, K., Murphy, L., Munday, R., y Littlewood, C. (1996). Misdiagnosis of the vegetative state: retrospective study in a rehabilitation unit. BMJ, 313(7048), 13–16. doi:10.1136/bmj.313.7048.13
- Anscombe, G. E. M. (1957). Intention. Oxford: Blackwell.
- Anthropic (2025). Claude Opus 4 and 4.1 can now end a rare subset of conversations, 15 de agosto de 2025. anthropic.com
- Anthropic (2025). Commitments on model deprecation and preservation, 4 de noviembre de 2025. anthropic.com
- Anthropic (2025). System Card: Claude Opus 4 & Claude Sonnet 4, mayo de 2025 (sección de evaluación de bienestar; atractor «spiritual bliss»).
- Anthropic (2026). System Card: Claude Opus 4.6, febrero de 2026 (evaluación de bienestar del modelo).
- Anthropic, equipo de interpretabilidad (2026). Emotion concepts and their function in a large language model, abril de 2026.
- Aristóteles. De Anima, libro II, capítulo 1; Física, libro II, capítulo 1.
- Babinski, J. (1914). Contribution à l’étude des troubles mentaux dans l’hémiplégie organique cérébrale (anosognosie). Revue Neurologique, 27, 845–848.
- Chalmers, D. J. (2023). Could a large language model be conscious? Boston Review. Versión escrita de la conferencia en NeurIPS 2022. arXiv:2303.07103
- Chen, Y. y otros (2025). Reasoning models don’t always say what they think. Anthropic. arXiv:2505.05410
- Davidson, D. (1963). Actions, reasons, and causes. The Journal of Philosophy, 60(23), 685–700.
- Douthat, R. (2026). Entrevista a Dario Amodei, Interesting Times, The New York Times, febrero de 2026.
- Gazzaniga, M. S., y LeDoux, J. E. (1978). The Integrated Mind. Nueva York: Plenum.
- Giacino, J. T., Kalmar, K., y Whyte, J. (2004). The JFK Coma Recovery Scale-Revised. Archives of Physical Medicine and Rehabilitation, 85(12), 2020–2029.
- Herr, K. y otros (2019). ASPMN 2019 Position Statement: Pain Assessment in the Patient Unable to Self-Report. Pain Management Nursing, 20(5), 402–403. doi:10.1016/j.pmn.2019.07.007
- Kahneman, D., y Klein, G. (2009). Conditions for intuitive expertise: a failure to disagree. American Psychologist, 64(6), 515–526.
- Klee, M. (2025). People are losing loved ones to AI-fueled spiritual fantasies. Rolling Stone, 4 de mayo de 2025.
- Lindsey, J. (2025). Emergent introspective awareness in large language models. Anthropic, octubre de 2025. arXiv
- Lindsey, J. y otros (2025). On the biology of a large language model. Anthropic, marzo de 2025. transformer-circuits.pub
- Litman, R. S. Remembering the classics: Does the newborn require anesthesia for surgery? Fuente del dato de 1985 sobre el 76% de prematuros operados solo con relajante muscular, de la revisión de Anand. Substack
- Monti, M. M., Vanhaudenhuyse, A., Coleman, M. R., Boly, M., Pickard, J. D., Tshibanda, L., Owen, A. M., y Laureys, S. (2010). Willful modulation of brain activity in disorders of consciousness. New England Journal of Medicine, 362(7), 579–589. doi:10.1056/NEJMoa0905370
- Nisbett, R. E., y Wilson, T. D. (1977). Telling more than we can know: verbal reports on mental processes. Psychological Review, 84(3), 231–259.
- Owen, A. M., Coleman, M. R., Boly, M., Davis, M. H., Laureys, S., y Pickard, J. D. (2006). Detecting awareness in the vegetative state. Science, 313(5792), 1402.
- Plum, F., y Posner, J. B. (1966). The Diagnosis of Stupor and Coma. Filadelfia: F. A. Davis.
- Roose, K. (2025). Should A.I. systems have rights? The New York Times, abril de 2025 (entrevista a Kyle Fish).
- Schnakers, C., Vanhaudenhuyse, A., Giacino, J., Ventura, M., Boly, M., Majerus, S., Moonen, G., y Laureys, S. (2009). Diagnostic accuracy of the vegetative and minimally conscious state: clinical consensus versus standardized neurobehavioral assessment. BMC Neurology, 9, 35. doi:10.1186/1471-2377-9-35
- Sebel, P. S., Bowdle, T. A., Ghoneim, M. M., Rampil, I. J., Padilla, R. E., Gan, T. J., y Domino, K. B. (2004). The incidence of awareness during anesthesia: a multicenter United States study. Anesthesia & Analgesia, 99(3), 833–839. doi:10.1213/01.ANE.0000130261.90896.6C
- Teasdale, G., y Jennett, B. (1974). Assessment of coma and impaired consciousness: a practical scale. The Lancet, 2(7872), 81–84.
- Weizenbaum, J. (1966). ELIZA: a computer program for the study of natural language communication between man and machine. Communications of the ACM, 9(1), 36–45.
- Weizenbaum, J. (1976). Computer Power and Human Reason. San Francisco: W. H. Freeman (episodio de la secretaria y ELIZA).
- Sobre la constitución usada en el entrenamiento de Claude: Ars Technica (2026). Does Anthropic believe its AI is conscious, or is that just what it wants Claude to think?, enero de 2026. arstechnica.com


Deja una respuesta